
Qualcomm AI Engine Direct
Qualcomm AI Engine Direct (ранее QNN SDK) — механизм логического вывода на устройстве для каждой гарнитуры Snapdragon XR
Унифицированный низкоуровневый пакет SDK для развертывания ИИ, который направляет данные нейронной сети на оптимальный аппаратный ускоритель Qualcomm — Hexagon NPU, Adreno GPU, Kryo CPU или LPAI — и обеспечивает все взаимодействия с ИИ в каждой гарнитуре XR на базе Snapdragon.
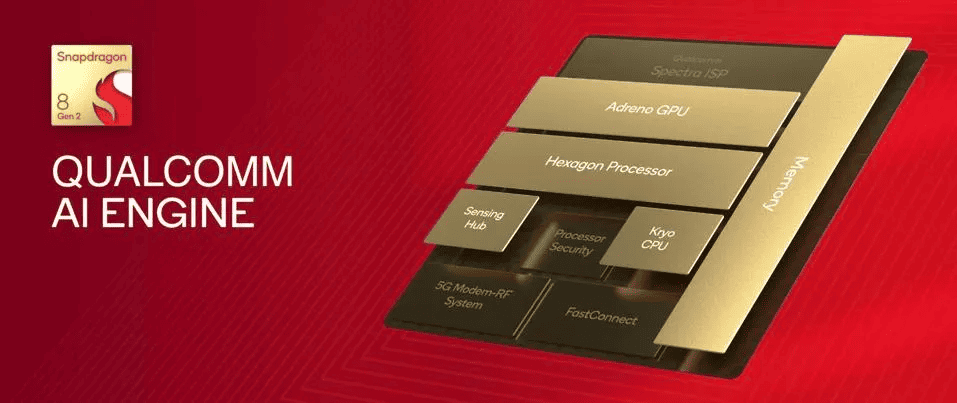
Что такое Qualcomm AI Engine Direct?
Qualcomm AI Engine Direct — ранее известный как QNN SDK (Qualcomm Neural Networks SDK), а теперь официально представленный как часть инструментария Qualcomm AI Runtime (QAIRT) — это унифицированный низкоуровневый набор для разработки программного обеспечения, который позволяет разработчикам развертывать рабочие нагрузки для вывода нейронных сетей на любом аппаратном ускорителе, доступном в Qualcomm Система Snapdragon на кристалле. А также Qualcomm AI Engine Direct предназначен для предоставления унифицированных низкоуровневых API-интерфейсов для разработки искусственного интеллекта. То есть помощью этих API разработчики могут взаимодействовать с различными ускорителями на SOC Qualcomm, включая процессоры Kryo CPU, Adreno GPU и Hexagon.
Итак в контексте XR и VR Qualcomm AI Engine Direct — это программная инфраструктура. Которая в свою очередь обеспечивает все взаимодействия с использованием искусственного интеллекта в гарнитуре на базе Snapdragon. В частности отслеживание движений рук, глаз, лица, распознавание жестов, прогнозирование положения головы, понимание пространственной сцены, распознавание голосовых команд и передачу данных в режиме реального времени усовершенствование. К гарнитурам, которые зависят от него, относятся Meta Quest 3 и Quest 3S, Pico 4 Ultra, Samsung Galaxy XR и любые другие устройства, построенные на платформе Snapdragon XR2 Gen 2 или XR2 + Gen 2.
SDK обеспечивает связь между высокоуровневыми платформами искусственного интеллекта — PyTorch, TensorFlow, ONNX — и конкретными наборами команд процессора Qualcomm Hexagon Tensor. Без этого модель, обученная в PyTorch, не сможет быть выполнена в Hexagon NPU. Как следствие с его помощью разработчик может взять любую модель ONNX. Безусловно преобразовать и количественно обработать ее, скомпилировать в двоичный код, зависящий от аппаратного обеспечения. В итоге запустить ее с полной производительностью HTP с помощью простого вызова API . Притом полностью на устройстве, полностью в автономном режиме, без обращения к облаку.
Четыре серверных части — один унифицированный API Qualcomm AI Engine Direct
Отличительной особенностью Qualcomm AI Engine Direct является его серверная модель абстракции. Один и тот же граф модели и одни и те же вызовы API могут быть перенаправлены на любой из четырех аппаратных ускорителей, просто изменив идентификатор серверной части при инициализации сеанса. SDK управляет всеми деталями, относящимися к конкретному оборудованию, — планированием команд, распределением памяти, преобразованием формата квантования — прозрачно для разработчика. В итоге каждая серверная часть имеет свой профиль производительности и энергопотребления. Что в свою очередь делает ее оптимальной для различных задач.
СЕРВЕРНАЯ часть HTP
Процессор Hexagon Tensor Processor (NPU)
Основная цель для всех высокопроизводительных вычислений в нейронных сетях. Ускоритель Hexagon Tensor Accelerator (HTA) обеспечивает выполнение до 16 000 операций многократного накопления за цикл с весами INT4. Требуются квантованные модели — минимум INT8, максимум INT4 для максимальной эффективности. QnnHtp.dll / libQnnHtp.so. Используется для отслеживания движений рук, глаз, лица, классификации жестов, оценки глубины, понимания сцены, определения голосовой активности.
СЕРВЕРНАЯ часть графического процессора
Adreno GPU
Эффективно обрабатывает операции, которые выполняются на графическом процессоре с широкой архитектурой SIMD, особенно в моделях с плавающей запятой, где квантование INT8 привело бы к большим потерям. QnnGpu.dll / libQnnGpu.so Поддерживает точность FP16 и FP32. Лучше всего подходит для конвейерной обработки изображений, нейронного рендеринга, переноса стилей, моделей, слишком больших для встроенной HTP-памяти. Не такой энергоэффективный, как HTP, для задач логического вывода.
СЕРВЕРНАЯ ЧАСТЬ процессора
Kryo CPU
Резервная серверная часть — выполняет логический вывод на процессорных ядрах Kryo на базе ARM Cortex. QnnCpu.dll / libQnnCpu.so. Поддерживает FP32 и INT8. Полезно для: отладки (детерминированный вывод), операторов, еще не поддерживаемых в HTP, моделей с динамическими формами (для HTP требуются статические формы). А также очень маленьких моделей, в которых затраты на планирование с помощью HTP перевешивают преимущество в производительности. В итоге для больших моделей это значительно медленнее и менее энергоэффективно, чем для HTP.
СЕРВЕРНАЯ часть LPAI
Маломощный искусственный интеллект (LPAI / Sensing Hub)
Постоянно работающий серверный модуль логического вывода с микроприводом, ориентированный на Qualcomm Sensing Hub — выделенный постоянно работающий процессор, работающий на микроваттах. QnnLpai / QnnSensorHub. Используется для: постоянного определения слова пробуждения. А также непрерывного мониторинга жестов в режиме ожидания / сна гарнитуры. К тому же определения присутствия устройства (надета гарнитура или выключена). И вместе с тем непрерывного мониторинга границ без пробуждения основного SoC.
Архитектура SDK Qualcomm AI Engine Direct
Графический API, двоичные файлы контекста и гетерогенная диспетчеризация
Qualcomm AI Engine Direct использует графическую модель выполнения. Разработчики (или используемые ими интеграционные платформы) строят графическую модель, используя QNN Graph API. Определяющий узлы (операции) и ребра (тензоры), которые SDK затем оптимизирует и компилирует для целевой серверной части. При производственных развертываниях этот этап компиляции выполняется заранее (AOT) для создания двоичного файла контекста — предварительно скомпилированного артефакта, зависящего от аппаратного обеспечения и платформы, который загружается и выполняется с минимальными затратами на инициализацию. Двоичный файл контекста QNN не зависит от операционной системы, но зависит от устройства, а двоичные файлы контекста предназначены только для NPU (серверной части HTP).
Для приложений XR необходима компиляция AOT. Модель отслеживания рук в виртуальной реальности, для компиляции которой требуется несколько секунд во время выполнения при первом запуске, неприемлема — гарнитура не сможет отслеживать руки до завершения компиляции. Контекстные двоичные файлы устраняют это: двоичный файл компилируется один раз на компьютере разработчика (или через облачный сервис Qualcomm AI Hub), поставляется вместе с приложением и загружается на устройство за миллисекунды. В качестве альтернативы, двоичный файл контекста QNN может быть встроен в модель ONNX для создания предварительно скомпилированной модели среды выполнения ONNX, которая работает в Android, Linux или Windows с помощью простого кода логического вывода.
Разнородная диспетчеризация — запуск разных уровней одной и той же модели на разных аппаратных платформах — прозрачно управляется системным уровнем Qualcomm AI Engine, частью которого является QNN SDK. Например, поставщик QNN для выполнения ONNX Runtime автоматически разбивает граф модели на разделы: поддерживаемые операторы отправляются в серверную часть HTP через QNN, в то время как неподдерживаемые операторы возвращаются в центральный процессор. Это обеспечивает максимальное использование аппаратного обеспечения, не требуя от разработчиков вручную разбивать свои модели на разделы.
Система квантования Qualcomm AI Engine Direct
Квантование — важнейший шаг для ускорения HTP
Наиболее важной концепцией для разработчиков, ориентированных на серверную часть HTP (Hexagon Tensor Processor), является квантование. Серверная часть QNN HTP поддерживает только квантованные модели. Модели с 32-разрядными активациями с плавающей запятой и весами должны быть предварительно обработаны квантованием, чтобы использовать меньшую целочисленную точность, прежде чем они смогут работать на HTP. Это необязательная оптимизация — это жесткое требование для ускорения NPU на оборудовании Qualcomm.
Квантование преобразует вещественные тензоры с плавающей запятой в целочисленные представления с использованием масштабного коэффициента и нулевой точки. Уровень точности оказывает прямое и существенное влияние как на скорость вывода, так и на точность модели. Квантованные модели могут повысить производительность HTP в 3 раза по сравнению с их аналогами с плавающей запятой. Компромиссом является потеря точности, которая должна быть определена с помощью калибровки. Использование набора калибровочных данных, который является репрезентативным для типичных входных данных модели, имеет решающее значение для создания точной квантованной модели.
Qualcomm AI Engine Direct SDK поддерживает несколько уровней точности. INT8 (8-разрядные целочисленные значения веса и активации) является стандартом для большинства моделей XR-трекинга. INT4 (4-разрядные веса) обеспечивает максимальную производительность аппаратного обеспечения Hexagon Tensor Accelerator с производительностью 16 000MAC за цикл, что идеально подходит для таких крупных моделей, как LLM, устанавливаемых на гарнитуры. Активации INT16 с весами INT8 (W8A16) — это промежуточный вариант с более высокой точностью. Активации FP16 поддерживаются на серверной части GPU и в некоторых конфигурациях HTP.
В частности, для HTP Qualcomm рекомендует и поддерживает количественную оценку после обучения (PTQ) с помощью набора инструментов AIMET (AI Model Efficiency Toolkit) и обучение с учетом количественной оценки (QAT) с помощью интеграции QnnQuantizer с PT2E flow от PyTorch. QnnQuantizer определяет конфигурации квантования и аннотации, совместимые с аппаратным обеспечением Qualcomm, при этом QuantDtype перечисляет комбинации разрядности для активаций и весов, а ModuleQConfig управляет поведением квантования на каждом уровне.
Рабочий процесс разработчика
От обучения до вывода HTP—кода — Полный конвейер Qualcomm AI Engine Direct
Рабочий процесс развертывания QNN состоит из шести основных этапов: от экспорта обученной модели до квантования, AOT-компиляции и логического вывода на устройстве. Понимание этого конвейера важно для любого разработчика XR, ориентированного на Hexagon NPU. Рабочий процесс также доступен через Qualcomm AI Hub Workbench. Облачный сервис, который выполняет преобразование моделей, количественную оценку и профилирование на реальном оборудовании Snapdragon без использования физических устройств.
Экспортируйте модель в ONNX
Обучите свою модель в PyTorch, TensorFlow или любом другом ML-фреймворке. Экспортируйте в формат ONNX — общий формат обмена, который принимают все инструменты QNN converter. Для PyTorch: torch.onnx.export(). Запустите рекомендованное Qualcomm задание ONNX—компиляции, даже если исходный код уже находится в ONNX — он выполняет этапы оптимизации перед вычислением количества.
Выполните квантование с помощью AIMET / QNN Quantizer
Преобразуйте ONNX-модель FP32 в квантованный QDQ (Quantise-Dequantise) ONNX с помощью утилит квантования ONNX Runtime или AIMET. Предоставьте калибровочные данные — реальные репрезентативные входные данные, а не случайные данные. Выберите точность: INT8 для большинства моделей XR, INT4 для максимальной производительности в LLMS. Только приведите все динамические формы к статическим значениям. Поскольку для HTP требуются известные тензорные размеры во время компиляции.
Преобразуйте в QNN IR с помощью qnn-onnx-конвертера
Запустите инструмент qnn-onnx-converter (часть QAIRT SDK) на квантованном ONNX, чтобы создать QNN model IR — промежуточное представление, специфичное для графического формата QNN. На этом этапе устраняются неподдерживаемые операторы, выполняется перезапись макета и выполняется вывод формы. Распространенные проблемы: неподдерживаемые операторы, сбои при выводе формы, несоответствие ограничений FP16 для определенных конфигураций SoC.
AOT-компиляция в контекстный двоичный файл
Используйте предварительную компиляцию для создания контекстного двоичного файла (.bin) для конкретной целевой платформы Snapdragon. На этом этапе выполняются все аппаратные оптимизации — объединение циклов, выделение памяти, планирование шестиугольных команд — заранее. Благодаря тому значительно сокращает время загрузки модели на устройство по сравнению с JIT—компиляцией. Двоичный контекст зависит от устройства, но не зависит от операционной системы. Например может быть встроен в модель ONNX для развертывания через ONNX Runtime.
Профиль с помощью qnn-net-run
Запустите qnn-net-run с помощью —profiling_level detailed, чтобы получить временные данные для каждого уровня в профиле JSON. Определите, какие уровни выполняются с использованием HTP или резервного процессора. Какие уровни работают медленно и не поддерживаются ли какие-либо операторы. Кстати подробное профилирование приводит к существенным затратам. Потому оно используется только для оптимизации, а не в рабочей среде. Впрочем AI Hub Workbench обеспечивает такое же профилирование через облако на реальном оборудовании.
Развертывание через QNN API / ONNX Runtime / ExecuTorch
Загружайте двоичный файл контекста при запуске приложения (миллисекунды, а не секунды). Для приложений для Android / XR: используйте QNN C API напрямую или через QNN Execution Provider среды выполнения ONNX (проще, он автоматически обрабатывает секционирование), или через серверный делегат QNN от PyTorch ExecuTorch. Установите режим performance mode на BURST для получения результатов XR-анализа в реальном времени. Запустите вывод в цикле отслеживания / искусственного интеллекта вашего приложения.
Интеграция с платформой Как экосистема подключается к Qualcomm AI Engine Direct
Qualcomm AI Engine Direct интегрирован в стек логического вывода каждой крупной платформы ML framework. Эти интеграции позволяют разработчикам использовать знакомые цепочки инструментов платформы. Автоматически направляя логический вывод в Hexagon NPU через уровень QNN SDK, расположенный ниже. Qualcomm AI Hub Workbench поддерживает TensorFlow Lite, ONNX Runtime и Qualcomm AI Engine Direct (контекстную двоичную систему и библиотеку моделей) в качестве целевых сред выполнения.
Приложения XR
Все функции искусственного интеллекта в гарнитуре Snapdragon XR используют Qualcomm AI Engine Direct
В случае гарнитур XR, таких как Meta Quest 3, Pico 4 Ultra или Samsung Galaxy XR, пакет Qualcomm AI Engine Direct SDK является программным обеспечением, обеспечивающим выполнение любой рабочей нагрузки с использованием искусственного интеллекта. Вы щелкаете пальцем, чтобы выбрать объект, модель QNN, работающая на HTP, классифицирует этот жест. В сквозном видео автоматически настраивается экспозиция, конвейер QNN обрабатывает кадр камеры. Когда гарнитура обнаруживает, что вы ее сняли, модель QNN на LPAI Sensing Hub обнаруживает ее отсутствие. Пакет SDK не является дополнительным уровнем оптимизации — это инфраструктура выполнения интеллектуальных функций устройства.
Отслеживание рук
Вывод скелета с 26 суставами по кадрам камеры RGB. Модель QNN INT8 на HTP. Должна работать со скоростью 90 кадров в секунду, привязанной к частоте кадров дисплея. Время ожидания: менее 5 мс на вывод. Используется в Meta Quest 3, Pico 4 Ultra, Samsung Galaxy XR.
Отслеживание движения глаз и Фовеация
Данные о центре зрачка и векторе взгляда с 4-х внутренних ИК-камер. QNN HTP выводит данные о фовеации на конвейер рендеринга. Также используется для биометрической идентификации радужной оболочки глаза в Galaxy XR (Iris ID).
Отслеживание лиц
Распознавание лицевых ориентиров и классификация выражений для систем аватаров. Модель QNN для HTP. Используется например в социальной виртуальной реальности. А также для совместной работы на предприятиях. И несомненно для рендеринга аватаров по образу и подобию в Galaxy XR и Vision Pro.
Понимание сцены
Оценка глубины, классификация поверхностей (пол, стена, потолок, стол) и 3D-реконструкция сцены. QNN HTP + Spectra ISP-конвейер. Обеспечивает постоянные пространственные привязки и привязку объектов смешанной реальности.
Сквозное улучшение
Безусловно подавление шума в реальном времени и нормализация экспозиции. А также отображение тонов HDR и вычисление стереоразличений на кадрах сквозной камеры. Помимо всего совместная обработка QNN + Spectra ISP с непрерывной задержкой 12 мс.
Распознавание голоса и слов после вызова
Постоянно включенное распознавание голосовой активности на серверной части LPAI/Sensing Hub со скоростью microwatts. Запускает пробуждение основного процессора SoC в зависимости от речевых намерений пользователя. Во время активного сеанса на HTP работает конвейер полной обработки голоса.
Логический вывод LLM на устройстве
Gemini Nano и аналогичные небольшие языковые модели преобразованы в INT4/W8A16 через QNN для локального логического вывода. Безусловно включает функции автономного помощника по ИИ. А также контекстные подсказки пользовательского интерфейса и ответы ИИ. Которые в свою очередь чувствительны к задержке, без облачных вычислений.
Прогноз положения головы
Прогноз положения головы с помощью искусственного интеллекта с помощью IMU + визуально-инерциальной одометрии fusion. К тому же модель QNN на HTP предсказывает положение головы во время отображения на 16 мс вперед. Чтобы как следствие компенсировать задержку рендеринга в конвейере отображения.
Сильные стороны и ограничения Qualcomm AI Engine Direct
Сильные стороны
- Единственная среда выполнения логического вывода, специально разработанная для конкретного ISA процессора Hexagon Tensor
- Четыре различных серверных интерфейса — HTP, GPU, CPU CPU, LPAI — объединены в рамках одного API
- Бинарная компиляция в контексте AOT: миллисекундное время загрузки модели в сравнении с секундами для JIT
- Увеличение пропускной способности до 3 раз для моделей с квантованием по сравнению с FP32 на HTP
- Поддержка INT4 позволяет запускать LLM, такие как Gemini Nano, локально на оборудовании гарнитуры
- Автоматическое разнородное разделение с помощью ONNX Runtime QNN EP
- Серверная часть LPAI Sensing Hub: постоянно включенный искусственный интеллект на микроваттах в режиме ожидания гарнитуры
- Богатая экосистема фреймворка: ONNX Runtime, ExecuTorch, TFLite, LiteRT, MATLAB
- AI Hub Workbench: облачное профилирование на реальном оборудовании Snapdragon без использования физических устройств
- Инструментарий количественной оценки с открытым исходным кодом AIMET снижает барьер для развертывания
- Пользовательские операционные пакеты позволяют расширять HTP с помощью нестандартных операторов
- Многоуровневая диспетчеризация: отсутствие регрессий при добавлении новых слоев модели
Ограничения
- Серверная часть HTP требует использования квантованных моделей — модели FP32 не могут запускаться на NPU
- В HTP отсутствует поддержка динамических форм — все тензорные формы должны быть исправлены во время компиляции
- Двоичные файлы контекста зависят от устройства — их необходимо компилировать отдельно для каждого варианта Snapdragon
- Покрытие операторов ONNX является подмножеством — циклы и операторы, не поддерживаемые HTP
- Утилиты квантования, которые в настоящее время доступны только на хостах x86_64 — ARM64, не могут выполнять квантование моделей
- Качество калибровочных данных имеет решающее значение — плохая калибровка приводит к снижению точности
- Фирменный SDK — с закрытым исходным кодом, только на оборудовании Qualcomm, без переносимости между поставщиками
- Automotive SDK отличается от mobile SDK отдельными инструментами для QNX/auto targets
- Подробное профилирование создает значительные накладные расходы, которые невозможно использовать в производственной среде
- Аппаратная поддержка FP16 зависит от конфигурации SoC — не всегда доступна на всех устройствах HTP
Вердикт: Необходимая инфраструктура искусственного интеллекта для автономного XR
Qualcomm AI Engine Direct — это, в практическом смысле, причина, по которой автономные гарнитуры XR могут делать все, что угодно. Хотя без него процессор Hexagon Tensor по своим техническим характеристикам соответствует кремниевому процессору. Но к сожалению недоступен для прикладного кода. С его помощью каждая крупная платформа ML framework может перенаправлять свои рабочие нагрузки для вывода данных на самый мощный ускоритель искусственного интеллекта на базе Snapdragon SoC. А также повышение производительности искусственного интеллекта , в итоге сделало возможным отслеживание рук без контроллера? QNN — это программный уровень, который сделал эту аппаратную производительность доступной для разработчиков приложений.
Безусловно необходимость количественной оценки является реальной и усложняет процесс разработки. Правильная калибровка модели, фиксация динамических форм. А также работа с неподдерживаемыми операторами и управление бинарной компиляцией в контексте конкретного устройства. В итоге все это серьезные проблемы, с которыми приходится сталкиваться разработчикам. Облачный сервис AI Hub Workbench, который предоставляет все эти этапы в виде управляемых заданий на реальном оборудовании, является эффективным решением этой проблемы, существенно снижая барьер для команд, не обладающих глубокими знаниями в области инфраструктуры ML.
Поддержка INT4 и растущая история внедрения LLM — таких моделей, как Gemini Nano, Phi-3 и LLaMA, с квантованием до 4-битных весов, полностью реализуемых на устройстве, — это то, что делает QNN наиболее перспективным для будущего XR. Гарнитура, которая поддерживает локальную языковую модель без задержек в облаке. А также отсутствие проблем с конфиденциальностью. В итоге может обеспечить поддержку искусственного интеллекта, подобную Gemini, в полностью автономных средах. Поскольку эта возможность станет стандартной в чипах Snapdragon XR следующего поколения. Как следствие QNN станет инфраструктурой, через которую каждый разработчик получит к ней доступ.